
اگست 2026 سے، بڑے AI اسسٹنٹس سے ملنے والا ٹیکسٹ اب صرف ٹیکسٹ نہیں رہا ہے۔ Claude اور Gemini اب ان الفاظ میں ایک شماریاتی واٹر مارک چھپا رہے ہیں جو وہ منتخب کرتے ہیں، اور OpenAI نے کہا ہے کہ ChatGPT کے لیے ٹیکسٹ اگلا ہے۔ آپ اسے نہیں دیکھ سکتے، لیکن فراہم کنندہ اس کی جانچ کر سکتا ہے، اور جو بھی شخص انہیں ڈیٹیکٹر کے پاس لے جائے، وہ بھی کر سکتا ہے۔ اگر آپ ویب سائٹس بناتے ہیں، کلائنٹس کے لیے لکھتے ہیں یا پیمانے پر شائع کرتے ہیں، تو یہاں یہ ہے کہ AI سے تیار کردہ ٹیکسٹ میں آج کیا ہے، اپنی خود کی مواد کیسے چیک کریں، AI واٹر مارکس کیسے ہٹائیں، اور پہلے سے صاف ٹیکسٹ کیسے جنریٹ کریں NoTrack API کے ساتھ۔
آپ کے مواد پر نامرئی لیبل
2 اگست 2026 کو EU AI Act (Article 50) کی شفافیت کے قواعد نافذ ہوئے۔ وہ جنریٹو AI کے فراہم کنندگان سے مطالبہ کرتے ہیں کہ وہ اپنے نظاموں سے پیدا کردہ چیزوں کو مشین پڑھنے کے قابل طریقے سے نشان زد کریں، تاکہ اسے AI سے تیار کردہ کے طور پر پہچانا جا سکے۔ بڑے لیبارٹریز نے تیزی سے حرکت کی۔
- Anthropic (Claude). 14 اگست 2026 کو Anthropic نے اعلان کیا کہ نئے Claude ماڈلز ایسا ٹیکسٹ جنریٹ کرتے ہیں جس میں واٹر مارک ہوتا ہے، اور پرانے ماڈلز اگلے مہینوں میں اپ ڈیٹ ہو رہے ہیں۔ ایک ڈیٹیکشن API پہلے سے ریگولیٹرز، قانون نافذ کرنے والے اداروں، میڈیا، فیکٹ چیکرز، محققین اور تعلیمی اداروں کے لیے پرائیویٹ پریویو میں ہے۔
- Google (Gemini). Gemini نے 2024 سے اپنا ٹیکسٹ آؤٹ پٹ واٹر مارک کر رہا ہے SynthID کے ساتھ، ایک طریقہ Google DeepMind نے نیچر میں شائع کیا اور 2024 میں اوپن سورس کیا۔ Claude کا واٹر مارک اسی نقطہ نظر پر مبنی ہے۔
- OpenAI (ChatGPT). OpenAI پہلے سے جنریٹ کردہ تصاویر اور آڈیو کو نشان زد کر رہا ہے اور کہا گیا ہے کہ وہ مواد کی اصل کو ٹیکسٹ تک پھیلانا چاہتا ہے۔ اطلاع کے مطابق اس نے اندرونی طور پر ایک ٹیکسٹ واٹر مارک بنایا ہے لیکن اسے ابھی تک لانچ نہیں کیا ہے۔
ایک عام صارف کے لیے جو صرف ایک نسخہ مانگ رہا ہو، اس سب کی کوئی اہمیت نہیں ہے۔ لیکن ان لوگوں کے لیے جو AI کی مدد سے لکھے گئے متن کو شائع کرتے ہیں، اسے بیچتے ہیں یا کلائنٹس کو فراہم کرتے ہیں، یہ کھیل بدل دیتا ہے: آپ کے مواد میں اب ایک ایسی دستخط شامل ہے جسے آپ نے شامل نہیں کیا، نہ دیکھ سکتے ہیں اور نہ ہی بند کر سکتے ہیں۔
AI متن کے واٹر مارک کی دو اقسام
"AI واٹر مارک" کا لفظ دو بالکل مختلف چیزوں کے لیے استعمال ہوتا ہے۔ یہ جاننا کہ آپ کس سے نمٹ رہے ہیں، یہ طے کرنے میں مدد دیتا ہے کہ اسے کیسے ہٹایا جائے۔
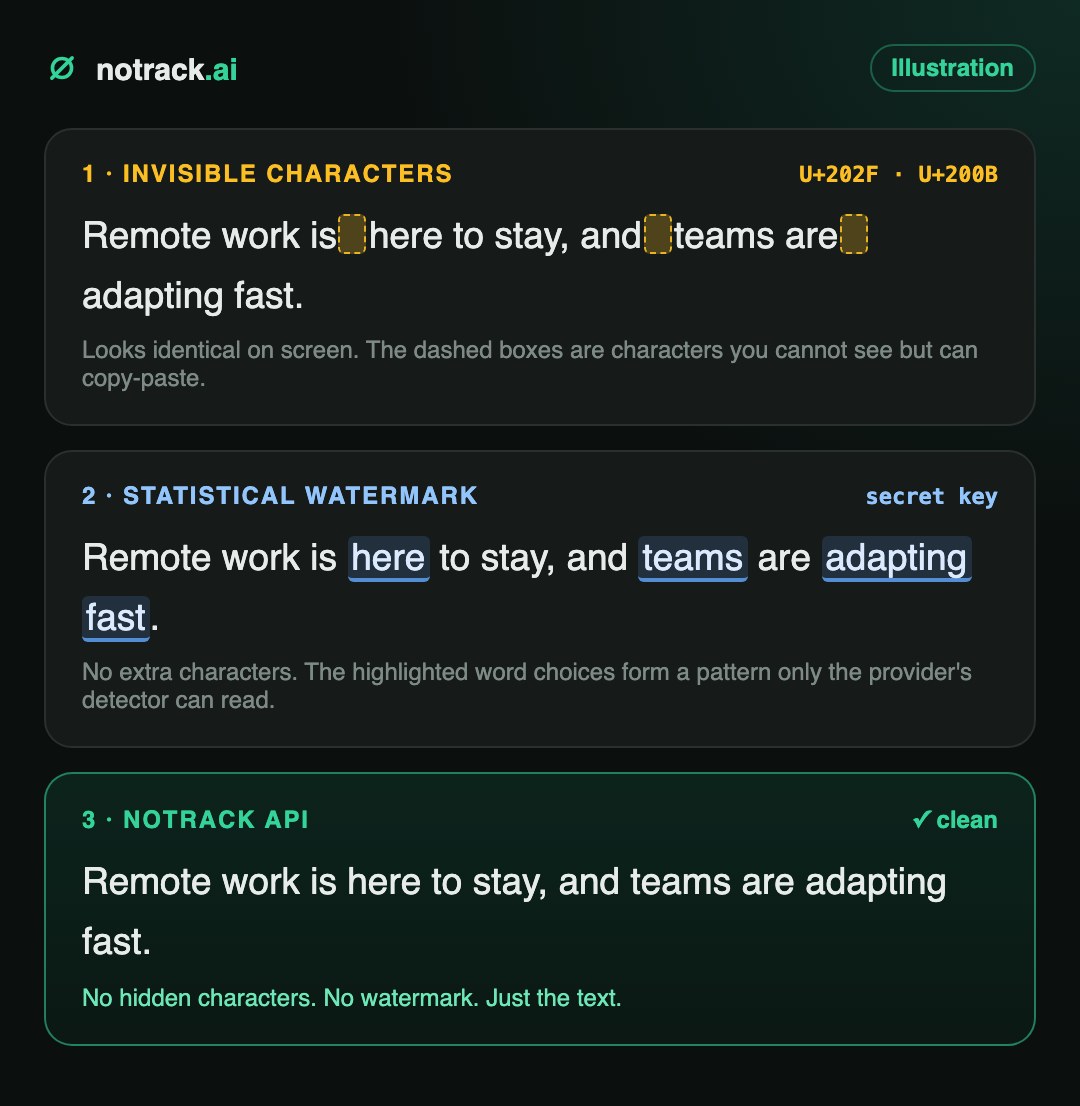
غیر مرئی حروف
Unicode ایسے حروف جو بالکل عام خلا یا کچھ بھی نہیں جیسے نظر آتے ہیں: زیرو وڈتھ سپیسز، ورڈ جائنرز، تنگ نو بریک اسپیسز۔
- ایک سادہ اسکرپٹ کے ساتھ آسانی سے پتہ چل سکتا ہے
- ہٹانا آسان ہے: انہیں ہٹا دیں یا تبدیل کر دیں
- خاموشی سے چیزوں کو خراب کریں: تلاش، الفاظ کی گنتی، کی ورڈ میچنگ، کوڈ
شماریاتی واٹر مارکس
بالکل کوئی اضافی حروف نہیں۔ ماڈل کے لفظی انتخاب ایک خفیہ کلید کے ذریعے کنٹرول کیے جاتے ہیں، جو ایک ایسا نمونہ چھوڑتے ہیں جسے صرف فراہم کنندہ کا ڈیٹیکٹر پڑھ سکتا ہے۔
- قاری اور کسی بھی ٹیکسٹ ایڈیٹر کے لیے غیر مرئی
- کاپی پیسٹ اور ہلکی پھلکی ترمیم کے بعد بھی برقرار رہتا ہے
- بھاری دوبارہ تحریر کرنے سے کمزور پڑ جاتا ہے؛ مکمل دوبارہ تحریر کرنے سے یہ ختم ہو جاتا ہے
نامرئی حروف: ChatGPT کا ایپی سوڈ
اپریل 2025 میں، محققین نے نوٹ کیا کہ OpenAI کے نئے o3 اور o4-mini ماڈلز سے حاصل کردہ متن میں U+202F (تنگ غیر ٹوٹنے والے خلا) ایسی جگہوں پر موجود تھے جہاں عام خلا ہونا چاہیے تھا۔ فارمیٹنگ مارکس آن کر کے اسے ورڈ میں پیسٹ کرنے پر یہ نقطوں کی جگہ چھوٹے سرکلز کے طور پر نظر آتے تھے۔ OpenAI نے بتایا کہ یہ حروف بڑے پیمانے پر تقویت یافتہ سیکھنے (reinforcement learning) کا ایک عجیب اثر تھے، نہ کہ کسی جان بوجھ کر لگائے گئے واٹر مارک، اور بعد میں یہ حروف ظاہر ہونا بند کر دیے۔ تاہم سبق یاد رہ گیا: اے آئی سے لکھا گیا متن ایسے حروف بھی ساتھ لے کر چل سکتا ہے جو آپ نظر نہیں کرتے، اور یہ آپ کے CMS میں ہر کاپی-پیسٹ کے ساتھ ساتھ چلے جاتے ہیں۔
شماریاتی واٹر مارکس: SynthID اور Claude
ایک لینگویج ماڈل ہر اگلے لفظ کو ممکنہ امیدواروں کی فہرست میں سے منتخب کرتا ہے، جس میں تھوڑی سی بے ترتیبی (randomness) بھی شامل ہوتی ہے۔ شماریاتی واٹر مارک اس بے ترتیبی کو ایک خفیہ کلید سے سیڈ شدہ جھوٹی بے ترتیب (pseudo-random) انتخاب سے بدل دیتا ہے۔ ایک قاری کے لیے متن بالکل معمولی لگتا ہے۔ لیکن اس شخص کے لیے جس کے پاس کلید ہو، کافی لمبا متن لفظوں کے انتخاب کا ایک ایسا نمونہ دکھاتا ہے جو اتفاق سے ہونے کے تقریباً ناممکن ہے۔
Claude کے منتخب کردہ لفظ اب بھی بے ترتیب ہیں، لیکن اب آپ لفظوں کے سلسلے کو چیک کر سکتے ہیں اور دیکھ سکتے ہیں کہ کیا یہ Claude کے ان انتخابوں کے ہم آہنگ ہے جو وہ اس کلید کا استعمال کرتے ہوئے کرتا۔
Anthropic، Claude کے ٹیکسٹ واٹر مارکنگ کا طریقہ کار (اگست 2026)
ناشرین کے لیے دو تفصیلات اہم ہیں۔ واٹر مارک متن کی لمبائی کے ساتھ زیادہ مضبوط ہوتا ہے، اور Anthropic کے مطابق، ہلکی پھلکی ایڈٹنگ اسے ختم نہیں کرتی، جبکہ ایسی مکمل دوبارہ تحریر جس میں ہر لفظ کو تبدیل کر دیا جائے، اسے ختم کر دے گی۔
اے آئی ٹیکسٹ میں واٹر مارک کون لگاتا ہے؟ (ستمبر 2026)
| فراہم کنندہ | ٹیکسٹ واٹر مارک | قسم | کون اسے چیک کر سکتا ہے |
|---|---|---|---|
| Google Gemini | جی ہاں، 2024 سے | شماریاتی (SynthID) | Google کے SynthID ٹولز |
| Anthropic Claude | جی ہاں، اگست 2026 کے بعد نئے ماڈلز | شماریاتی (SynthID پر مبنی) | Anthropic کی شناخت API، ریگولیٹرز، میڈیا، اساتذہ اور محققین کے لیے نجی پیش نظارہ |
| OpenAI ChatGPT | ابھی متن پر نہیں؛ تصاویر اور آواز پہلے سے نشان زد ہیں | متن کی اصلیت کو ایک ہدف کے طور پر اعلان کیا گیا | OpenAI ٹولز (آج تصاویر اور آواز) |
| NoTrack API | نہیں | کوئی واٹر مارک نہیں، کوئی چھپے ہوئے حروف نہیں | کوئی بھی نہیں |
واٹر مارک شدہ متن مواد تخلیق کاروں کے لیے کیوں نقصان دہ ہے
Google برسوں سے یہ کہتا آ رہا ہے کہ یہ معیار کی بنیاد پر مواد کو درجہ بندی کرتا ہے، نہ کہ اس کی تیاری کے طریقے کی بنیاد پر۔ مسئلہ یہ ہے کہ زنجیر کا باقی حصہ۔
- آپ کے کلائنٹس اس کی جانچ کر سکتے ہیں۔ اےجنسیاں اور فری لانسرز وہ متن فراہم کرتے ہیں جو اب زیادہ تر لوگ ادائیگی سے پہلے AI چیک سے گزارتے ہیں۔ واٹر مارک "AI کی مدد سے تیار اور احتیاط سے ایڈٹ شدہ" کو بغیر کسی لچک کے "فلیگ شدہ" بنا دیتا ہے۔
- پلیٹ فارمز اور مارکیٹ پلیسز اسکرین کرتے ہیں۔ پبلشنگ پلیٹ فارمز، فری لانس مارکیٹ پلیسز، اشتہاری نیٹ ورکس اور ریویو سائٹس AI ڈیٹیکشن شامل کر رہے ہیں۔ ایک قابلِ شناخت سگنیچر فلٹر کرنے کے لیے سب سے آسان چیز ہے۔
- یہ آپ کے ورک فلو کو ظاہر کرتا ہے۔ ایک واٹر مارک کسی بھی ڈیٹیکٹر رکھنے والے کو بتا دیتا ہے کہ آپ کا مواد کس ٹول نے لکھا ہے۔ ایک مواد کی کمپنی کے لیے، یہ مقابلے کی معلومات ہیں جن کے شائع کرنے کی آپ نے کبھی اجازت نہیں دی۔
- یہ متن کے ساتھ ہر جگہ جاتا ہے۔ سندیکٹ شدہ، ہلکا پھلکا ترجمہ شدہ یا دوبارہ پوسٹ شدہ، واٹر مارک شدہ متن اپنی سگنیچر برقرار رکھتا ہے۔ آپ اس کی نگرانی نہیں کر سکتے جسے آپ دیکھ نہیں سکتے۔
- چھپے ہوئے حروف چیزوں کو خراب کر دیتے ہیں۔ نامرئی Unicode خاموشی سے سائٹ پر تلاش، ایکٹ میچ کی ورڈز، ورڈ کاؤنٹ، سپیل چیکرز اور کسی بھی کوڈ کو توڑ دیتا ہے جو آپ پیسٹ کرتے ہیں۔ یہ دو ایک جیسی نظر آنے والی صفحات کو بائٹ بر بائٹ مختلف بھی بنا سکتا ہے۔
اپنے متن کو AI واٹر مارکس کے لیے چیک کرنے کا طریقہ
1. نامرئی حروف: سیکنڈوں میں چیک کریں
فوری دستی ٹیسٹ: متن کو Microsoft Word میں پیسٹ کریں اور فارمیٹنگ مارکس دکھانے کے لیے Ctrl+Shift+8 (Mac پر Cmd+8) دبائیں۔ عام خلائی جگہیں ڈاٹس کے طور پر ظاہر ہوتی ہیں؛ خاص خلائی جگہیں چھوٹے سرکلز یا دیگر علامتوں کے طور پر ظاہر ہوتی ہیں۔ کسی بھی پیمانے کے لیے، ایک اسکرپٹ استعمال کریں:
import unicodedata

SUSPECT = {0x00A0, 0x202F, 0x2007, 0x2009, 0x200A, 0x205F, 0x3000,
           0x200B, 0x200C, 0x200D, 0x2060, 0xFEFF, 0x00AD}

def find_hidden(text: str):
    hits = []
    for i, ch in enumerate(text):
        if ord(ch) in SUSPECT or unicodedata.category(ch) == "Cf":
            hits.append((i, f"U+{ord(ch):04X}", unicodedata.name(ch, "?")))
    return hits

print(find_hidden(open("article.txt", encoding="utf-8").read()))
ایک اہم بات جس سے آگاہ ہونا ضروری ہے: زیرو ویدتھ جوائنر (U+200D) ایموجی کا ایک جائز حصہ بھی ہے، جیسے 🚴♂️۔ اگر کوئی نشان ایموجی کے اندر موجود ہو، تو اسے چھوڑ دیں۔
2. شماریاتی واٹر مارکس: انہیں آپ خود چیک نہیں کر سکتے
متن میں دیکھنے کے لیے کچھ نہیں ہے۔ صرف فراہم کنندہ کا ڈیٹیکٹر، جو سیکرٹ کیے کو جانتا ہے، یہ بتا سکتا ہے کہ کوئی حصہ واٹر مارکڈ ہے یا نہیں۔ Anthropic کا ڈیٹیکشن API منتخب اداروں کے لیے پرائیویٹ پریویو میں ہے، عوام کے لیے نہیں۔ عملی طور پر اس کا مطلب یہ ہے کہ آپ کو یہ فرض کرنا چاہیے: اگر واٹر مارکنگ ماڈل نے اسے لکھا ہے اور آپ نے اسے مکمل طور پر دوبارہ نہیں لکھا ہے، تو اس پر نشان لگا ہوا ہے۔
متن سے AI واٹر مارکس کو کیسے ہٹائیں
- نامرئی حروف کو ہٹائیں۔ خاص اسپیسز کو عام اسپیسز سے تبدیل کریں اور زیرو ویدتھ حروف کو حذف کریں۔ محفوظ، فوری اور بغیر کسی نقصان کے۔
- مکمل طور پر ایک آزاد ماڈل سے دوبارہ لکھیں۔ ہلکی پھلکی تدبیلات شماریاتی واٹر مارک کو برقرار رکھتی ہیں۔ مکمل دوبارہ تحریر، جہاں جملوں کی ساخت اور الفاظ کا انتخاب پورے متن میں تبدیل ہو جاتا ہے، اسے ختم کر دیتی ہے۔ ایسے ماڈل کا استعمال کریں جو اپنی پیداوار پر واٹر مارک نہ لگاتا ہو، ورنہ آپ صرف ایک سگنیچر کو دوسرے سے بدل رہے ہوں گے۔
- انداز کو انسانی بنائیں۔ مکمل دوبارہ تحریر اور ہمارے AI متن کو انسانی بنانے کے گائیڈ سے ہومینائزر پرامپٹ، وہ عام جملے اور وہ یکساں رفتار ہٹا دیتے ہیں جو ڈیٹیکٹرز کو پسند ہوتے ہیں۔
- ایک بار پھر اسکین کریں۔ شائع کرنے سے پہلے دوبارہ حروف کی جانچ چلائیں۔ اس میں صرف ایک سیکنڈ لگتا ہے۔
کوڈ میں مرحلہ 1: حروف کو صاف کریں
import re

SPACES = r"[\u00A0\u202F\u2007\u2009\u200A\u205F\u3000]"
ZERO_WIDTH = r"[\u200B\u200C\u2060\uFEFF\u00AD]"

def clean(text: str) -> str:
    text = re.sub(SPACES, " ", text)
    return re.sub(ZERO_WIDTH, "", text)
کوڈ میں مرحلہ 2: NoTrack API کے ذریعے مکمل دوبارہ تحریر
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

REWRITE = ("Rewrite the user's text from scratch in your own words, the way a sharp "
           "human writer would say it to a friend. New sentence structure and new word "
           "choice everywhere, same meaning and every fact kept. Plain everyday words, "
           "contractions, short and long sentences mixed. No em dashes. "
           "Output only the rewrite.")

def rewrite(text: str) -> str:
    r = client.chat.completions.create(
        model="notrack-uncensored",
        temperature=0.9,
        messages=[{"role": "system", "content": REWRITE},
                  {"role": "user", "content": clean(text)}],
    )
    return r.choices[0].message.content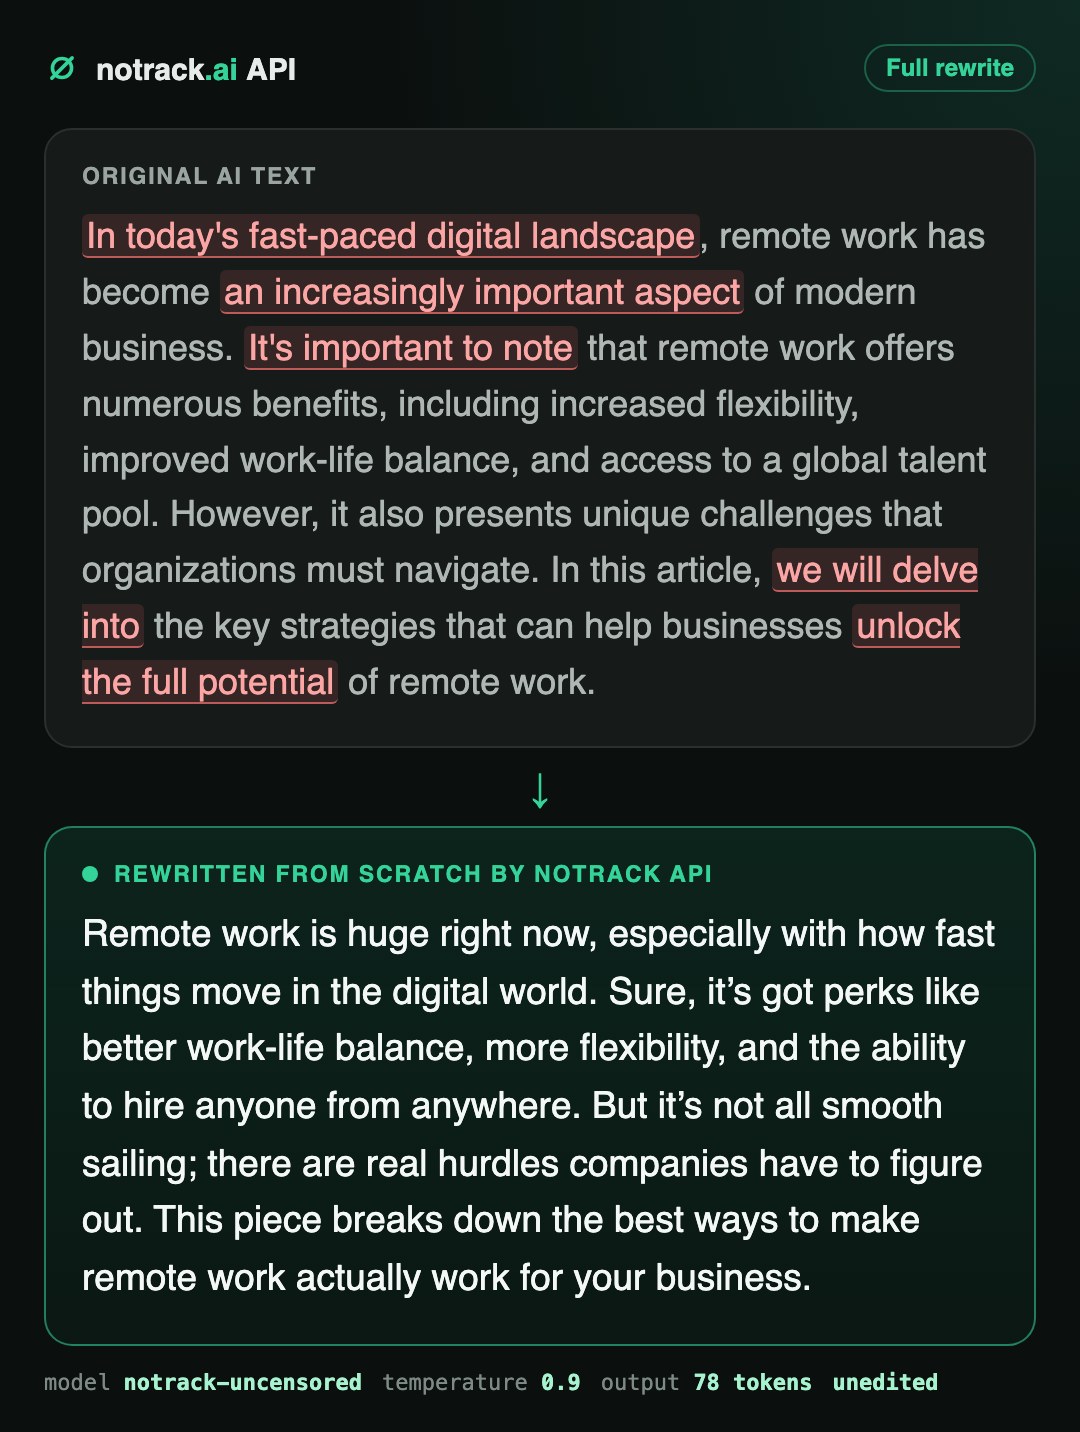
لمبے دستاویزات کو حصہ وار دوبارہ لکھیں۔ اس سے معیار برقرار رہتا ہے اور یقینی بناتا ہے کہ متن کا ہر حصہ دوبارہ لکھا جائے، نہ کہ صرف آغاز۔
یا واٹر مارک کو مکمل طور پر چھوڑ دیں
بعد میں متن کو صاف کرنا کام کرتا ہے۔ صاف کرنے کے لیے کچھ نہ ہونا بہتر کام کرتا ہے۔ NoTrack API اپنی غیر جانبدار ماڈل کو اپنی GPU پر چلاتا ہے۔ یہ OpenAI، Anthropic یا Google کے گرد ایک wrapper نہیں ہے، اس لیے کوئی اوپر والا فراہم کنندہ آپ کے متن پر اپنا سگنیچر نہیں لگاتا۔
- کوئی واٹر مارک نہیں۔ NoTrack کی آؤٹ پٹ میں کوئی شماریاتی واٹر مارک اور نہ ہی پرووینینس سگنچر ہوتا ہے۔ یہ متن آپ کا ہے، اس کے ساتھ کچھ اور منسلک نہیں ہوتا۔
- کوئی چھپے ہوئے حروف نہیں، پیمائش شدہ۔ ہم نے 26 NoTrack API جوابات، تقریباً 20,000 حروف، کو زرو ویدتھ اور خاص اسپیس حروف کے لیے اسکین کیا۔ ایک ایموجی کے علاوہ، گنتی صفر تھی۔
- کوئی لاگ نہیں۔ پرومپٹس اور جوابات کبھی ڈسک پر نہیں لکھے جاتے، نہ ہی گیٹ وے کی طرف سے اور نہ ہی ماڈل سرورز کی طرف سے۔ ہم بلنگ کے لیے ایک درخواست کی شناخت (request ID) اور ٹوکن کی گنتی رکھتے ہیں۔ کوئی بھی آپ کے مواد کو بعد میں تلاش نہیں کر سکتا۔
- کوئی ٹاپک فلٹر نہیں۔ نائٹ لائف، ڈیٹنگ، بالغ، قمار، کرپٹو، ڈارک فکشن: ماڈل وہ لکھتا اور دوبارہ لکھتا ہے جسے مین اسٹریم اسسٹنٹس مسترد کرتے ہیں یا پانی ڈال دیتے ہیں۔
- دو لائنوں کا سوئچ۔ OpenAI کے مطابق۔ بیس یو آر ایل کو
https://api.notrack.ai/v1پر تبدیل کریں اور کلید کو، اپنے کوڈ، ٹولز اور پلگ انز کا باقی حصہ برقرار رکھیں۔
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

article = client.chat.completions.create(
    model="notrack-uncensored",
    messages=[{"role": "user", "content": "Write a 600-word guide to choosing trail running shoes."}],
).choices[0].message.content

# Clean from the start: no watermark to remove, no hidden characters to strip.
print(article)
800 الفاظ کے 1,000 مضامین لکھنے کی لاگت تقریباً $1.10 آؤٹ پٹ ٹوکنز میں آتی ہے۔ آپ کی پہلی کلید پر مفت کریڈٹ اس پورے ورک فلو کو ٹیسٹ کرنے کے لیے کافی ہے اس سے پہلے کہ آپ ایک سینٹ خرچ کریں۔ اپنی کلید بنائیں یا API دستاویزات پڑھیں۔
اکثر پوچھے جانے والے سوالات
کیا ChatGPT اپنے متن پر واٹر مارک لگاتا ہے؟
ستمبر 2026 تک نہیں۔ OpenAI جنریٹڈ تصاویر اور آڈیو پر نشان لگاتا ہے اور کہا ہے کہ وہ اصلیت (provenance) کو متن تک بھی پھیلانا چاہتا ہے۔ اپریل 2025 میں کچھ ChatGPT ماڈلز نے نامرئی تنگ نوبریک اسپیسز (no-break spaces) پیدا کیں، جسے OpenAI نے واٹر مارک کی بجائے ٹریننگ کا ایک عجیب رویہ قرار دیا۔
کیا Claude اپنے متن پر واٹر مارک لگاتا ہے؟
ہاں۔ Anthropic نے اگست 2026 میں اعلان کیا کہ نئے Claude ماڈلز Google کے SynthID پر مبنی ایک شماریاتی طریقہ کار کا استعمال کرتے ہوئے واٹر مارک شدہ متن تیار کرتے ہیں، اور پرانے ماڈلز کو اپ ڈیٹ کیا جا رہا ہے۔ واٹر مارک میں کوئی اضافی حروف شامل نہیں ہوتے؛ یہ الفاظ کے انتخاب میں پنہاں ہوتا ہے۔
کیا Gemini اپنے متن پر واٹر مارک لگاتا ہے؟
ہاں۔ Google نے 2024 سے Gemini کے متن کی آؤٹ پٹ کو SynthID کے ذریعے واٹر مارک کیا ہے۔
کیا میں کچھ الفاظ میں ترمیم کر کے واٹر مارک ہٹا سکتا ہوں؟
نہیں۔ شماریاتی واٹر مارک ہلکی ترمیم کے باقی رہ جاتے ہیں۔ Anthropic خود نوٹ کرتا ہے کہ اگر مکمل طور پر دوبارہ لکھا جائے اور ہر لفظ کو تبدیل کر دیا جائے تو واٹر مارک ختم ہو جاتا ہے۔ کسی ایسے ماڈل سے مکمل طور پر دوبارہ لکھیں جو اپنا واٹر مارک شامل نہ کرے۔
ChatGPT یا Claude واٹر مارک ہٹانے والا کیا ہے؟
یہ ایک دو مرحلہ عمل ہے: نامرئی حروف کو ہٹائیں، پھر متن کو ایک آزاد ماڈل سے مکمل طور پر دوبارہ لکھیں۔ اوپر دیے گئے Python سنیپٹس دونٹ کرتے ہیں، اس میں سے NoTrack API کو دوبارہ تحریر کے لیے استعمال کرتے ہیں۔
کیا NoTrack API واٹر مارک یا چھپے ہوئے حروف شامل کرتا ہے؟
نہیں۔ NoTrack اپنی ہی ہارڈویئر پر اپنا ماڈل چلاتا ہے اور نہ تو واٹر مارک شامل کرتا ہے، نہ ہی اصلیت (provenance) کا سگنل اور نہ ہی کوئی چھپا ہوا حروف۔ یہ آپ کے پرامپٹس یا آؤٹ پٹس کو بھی محفوظ نہیں رکھتا۔
کیا Google AI سے تیار شدہ مواد پر پینلٹی لگاتا ہے؟
Google نے کہا ہے کہ وہ مددگار اور اعلیٰ معیار کے مواد کو اس کے تولید کے طریقے سے قطع نظر انعام دیتا ہے۔ واٹر مارک رینکنگ کے لیے کم اہم ہیں اور زیادہ اس بات کے لیے کہ آپ مواد کس لوگوں اور پلیٹ فارمز تک پہنچا رہے ہیں۔