
自 2026 年 8 月起,来自大型 AI 助手的文本不再仅仅是文本。Claude 和 Gemini 现在会在其选用的词汇中隐藏一种统计水印,而 OpenAI 已表示文本将是 ChatGPT 的下一个目标。你无法直接看到它,但提供商可以检测它,他们也可以将检测工具交给任何人使用。如果你构建网站、为客户撰写内容或进行大规模发布,以下是今天 AI 生成文本中包含的内容、如何检测你自己的内容、如何移除 AI 水印,以及如何从一开始就使用 NoTrack API 生成纯净文本的指南。
你内容上的隐形标签
2026 年 8 月 2 日,欧盟《人工智能法案》(第 50 条) 的透明度规则开始生效。该规则要求生成式 AI 提供商以机器可读的方式标记其系统生成的内容,以便将其识别为 AI 生成内容。各大实验室行动迅速。
- Anthropic(Claude)。 2026 年 8 月 14 日,Anthropic 宣布,新的 Claude 模型生成的文本包含水印,旧模型将在随后的几个月内更新。一个检测 API 已经在监管机构、执法部门、媒体、事实核查人员、研究人员和教育机构中进行私人预览。
- Google(Gemini)。 自 2024 年起,Gemini 已对其文本输出添加水印,使用的是 SynthID,这是一种由 Google DeepMind 发表在《自然》杂志上并于 2024 年开源的方法。Claude 的水印基于相同的方法构建。
- OpenAI(ChatGPT)。 OpenAI 已经对其生成的图像和音频进行标记,并表示希望将 内容溯源 扩展到文本领域。据报道,它已在内部构建了文本水印,但尚未发布。
对于只是询问食谱的普通用户来说,这无关紧要。但对于任何发布、出售或向客户交付 AI 辅助文本的人来说,这改变了游戏规则:你的内容现在带有你未添加、无法查看且无法关闭的签名。
两种 AI 文本水印
"AI 水印"一词用于两种截然不同的事物。了解你面对的是哪一种,将决定你如何去除它。
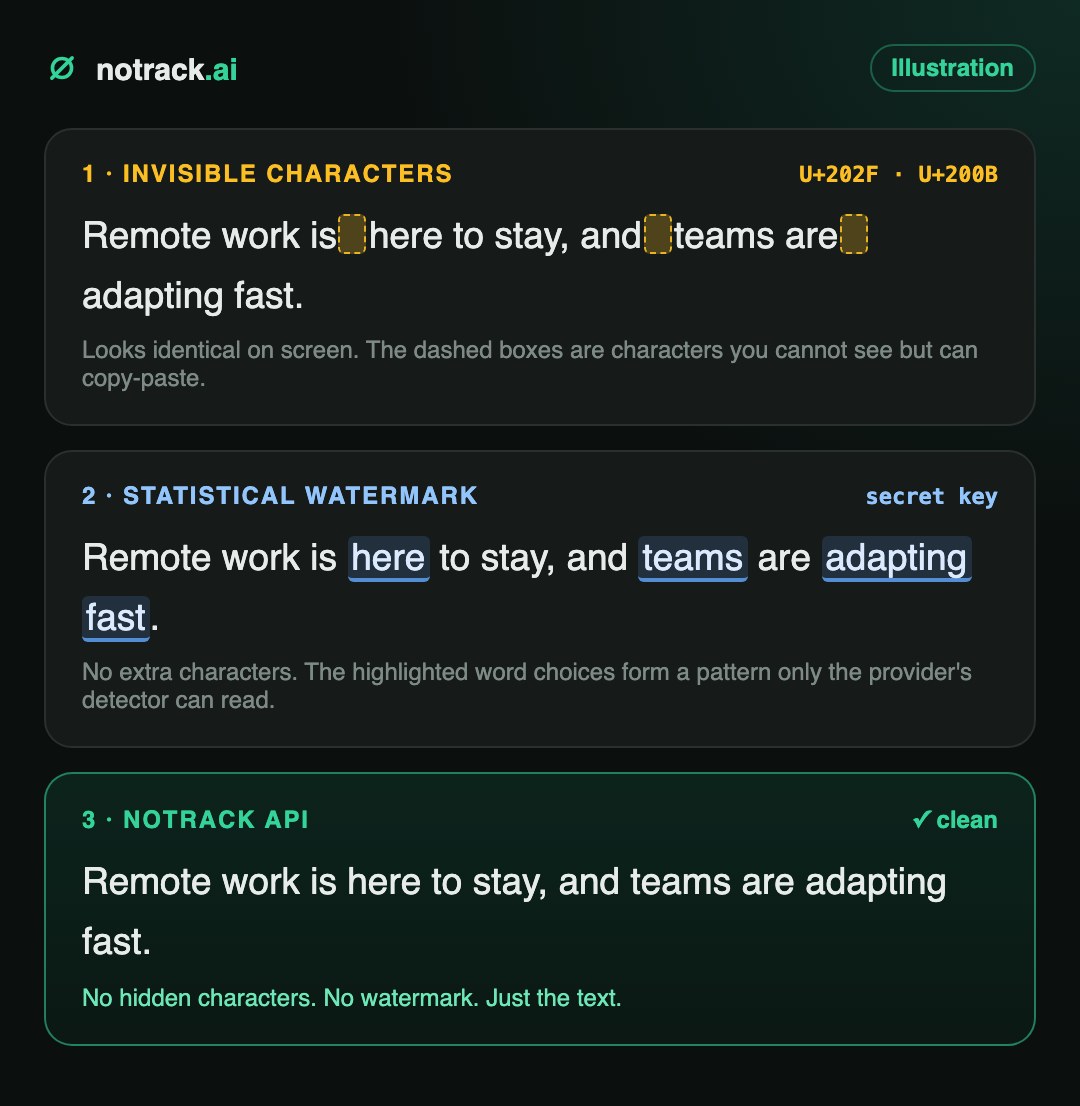
不可见字符
Unicode 字符,看起来与正常空格或完全无字符一样:零宽空格、单词连接符、窄距不换行空格。
- 通过简单脚本即可检测
- 易于移除:剥离或替换它们
- 悄然破坏功能:搜索、字数统计、关键词匹配、代码
统计水印
没有任何额外字符。模型的用词选择由密钥引导,留下一种只有提供商的检测器才能读取的模式。
- 对读者和任何文本编辑器均不可见
- survives 复制粘贴和轻度编辑
- 经过大幅改写后会减弱;完全重写则会将其消除
不可见字符:ChatGPT 剧集
2025年4月,研究人员发现,OpenAI 当时新推出的 o3 和 o4-mini 模型生成的文本中,在原本应为普通空格的地方出现了窄距不间断空格(U+202F)。在开启格式标记的 Word 中粘贴时,它们显示为小圆圈而非圆点。OpenAI 表示这些字符是大规模强化学习带来的一个怪癖,而非刻意添加的水印,且这些字符随后不再出现。尽管如此,这一教训依然深刻:AI 生成的文本可能携带你看不见的字符,并且它们会随着每一次复制粘贴进入你的 CMS。
统计水印:SynthID 与 Claude
语言模型从一系列可能的候选词中选择下一个词,并带有一定的随机性。统计水印用由密钥伪随机生成的随机选择取代了这种随机性。对读者而言,文本看起来完全正常;但对于持有密钥的人来说,足够长的文本段落会显示出一种几乎不可能由偶然产生的词序模式。
Claude 选择的词汇仍然是随机的,但现在人们可以检查词汇序列,看其是否与 Claude 在使用该密钥时所做的选择一致。
Anthropic,Claude 文本水印的工作原理(2026年8月)
对于出版商而言,有两个细节至关重要。水印的强度随文本长度的增加而增强,且根据 Anthropic 的说法,轻度编辑无法去除水印,而将所有词汇替换的完全重写则可以。
谁对 AI 文本进行了水印处理(2026年9月)
| 提供商 | 文本水印 | 类型 | 谁能进行检测 |
|---|---|---|---|
| Google Gemini | 是的,自2024年起 | 统计类(SynthID) | Google的SynthID工具 |
| Anthropic Claude | 是的,自2026年8月起的新模型 | 基于统计的(SynthID) | Anthropic检测API,面向监管机构、媒体、教育工作者和研究人员的私有预览 |
| OpenAI ChatGPT | 文本尚未支持;图像和音频已标记 | 文本溯源已宣布为既定目标 | OpenAI工具(图像和音频目前可用) |
| NoTrack API | 否 | 无水印,无隐藏字符 | 无人 |
为何带水印的文本会损害内容创作者
Google多年来一直表示,它根据内容质量进行排名,而不是根据内容的生产方式。问题出在链条上的其他人。
- 你的客户可以检查。 代理机构和自由职业者将文本交付给越来越多的人,他们在付款前会运行 AI 检测。水印将“AI 辅助并经过精心编辑”的内容变为“已标记”,没有回旋余地。
- 平台和交易市场进行筛选。 发布平台、自由职业市场、广告网络和评论网站正在增加 AI 检测。可检测的签名是最容易过滤的东西。
- 它揭示了你的工作流程。 水印告诉任何拥有检测器的人你的内容是由哪个工具编写的。对于内容业务来说,这是你从未同意发布的竞争信息。
- 它随文本无处不在。 经过转载、轻度翻译或重新发布,带有水印的文本保留其签名。你无法审计你看不见的东西。
- 隐藏字符会破坏东西。 不可见的 Unicode 会悄悄破坏站内搜索、精确匹配关键词、字数统计、拼写检查器以及你粘贴的任何代码。它还可以使两个看起来相同的页面在字节层面存在差异。
如何检查文本中的 AI 水印
1. 隐藏字符:几秒内检查
快速手动测试:将文本粘贴到 Microsoft Word 中,然后按 Ctrl+Shift+8(Mac 上为 Cmd+8)显示格式标记。普通空格显示为点;特殊空格显示为小圆圈或其他符号。对于任何规模的工作,请使用脚本:
import unicodedata

SUSPECT = {0x00A0, 0x202F, 0x2007, 0x2009, 0x200A, 0x205F, 0x3000,
           0x200B, 0x200C, 0x200D, 0x2060, 0xFEFF, 0x00AD}

def find_hidden(text: str):
    hits = []
    for i, ch in enumerate(text):
        if ord(ch) in SUSPECT or unicodedata.category(ch) == "Cf":
            hits.append((i, f"U+{ord(ch):04X}", unicodedata.name(ch, "?")))
    return hits

print(find_hidden(open("article.txt", encoding="utf-8").read()))
一个值得了解的小细节:零宽连接符(U+200D)也是许多表情符号(如 🚴♂️)的合法组成部分。如果命中出现在表情符号内部,请保留原样不动。
2. 统计水印:无法自行检测
文本表面看不出任何痕迹。只有持有密钥的提供商检测器才能判断某段文本是否带有水印。Anthropic 的检测 API 目前仅面向部分机构进行内部预览,未向公众开放。实际上这意味着:如果该文本由水印模型生成且你未对其进行彻底重写,它就会被标记。
如何去除文本中的 AI 水印
- 清除不可见字符。 将特殊空格替换为普通空格,并删除零宽字符。安全、即时且无损。
- 使用独立模型彻底重写。 轻微编辑会让统计水印保持完整。而彻底重写会改变整篇文本的句子结构和用词,从而消除水印。使用一种不对自身输出进行水印处理的模型,否则你只是用一种签名替换了另一种。
- 让文风更具“人味”。 彻底重写并结合我们 AI 文本人性化指南 中的人机提示词,可以去除检测器偏爱的套路化短语和呆板的节奏。
- 再次扫描。 在发布前再次运行字符检查。只需几秒钟。
代码步骤 1:清理字符
import re

SPACES = r"[\u00A0\u202F\u2007\u2009\u200A\u205F\u3000]"
ZERO_WIDTH = r"[\u200B\u200C\u2060\uFEFF\u00AD]"

def clean(text: str) -> str:
    text = re.sub(SPACES, " ", text)
    return re.sub(ZERO_WIDTH, "", text)
代码步骤 2:通过 NoTrack API 进行彻底重写
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

REWRITE = ("Rewrite the user's text from scratch in your own words, the way a sharp "
           "human writer would say it to a friend. New sentence structure and new word "
           "choice everywhere, same meaning and every fact kept. Plain everyday words, "
           "contractions, short and long sentences mixed. No em dashes. "
           "Output only the rewrite.")

def rewrite(text: str) -> str:
    r = client.chat.completions.create(
        model="notrack-uncensored",
        temperature=0.9,
        messages=[{"role": "system", "content": REWRITE},
                  {"role": "user", "content": clean(text)}],
    )
    return r.choices[0].message.content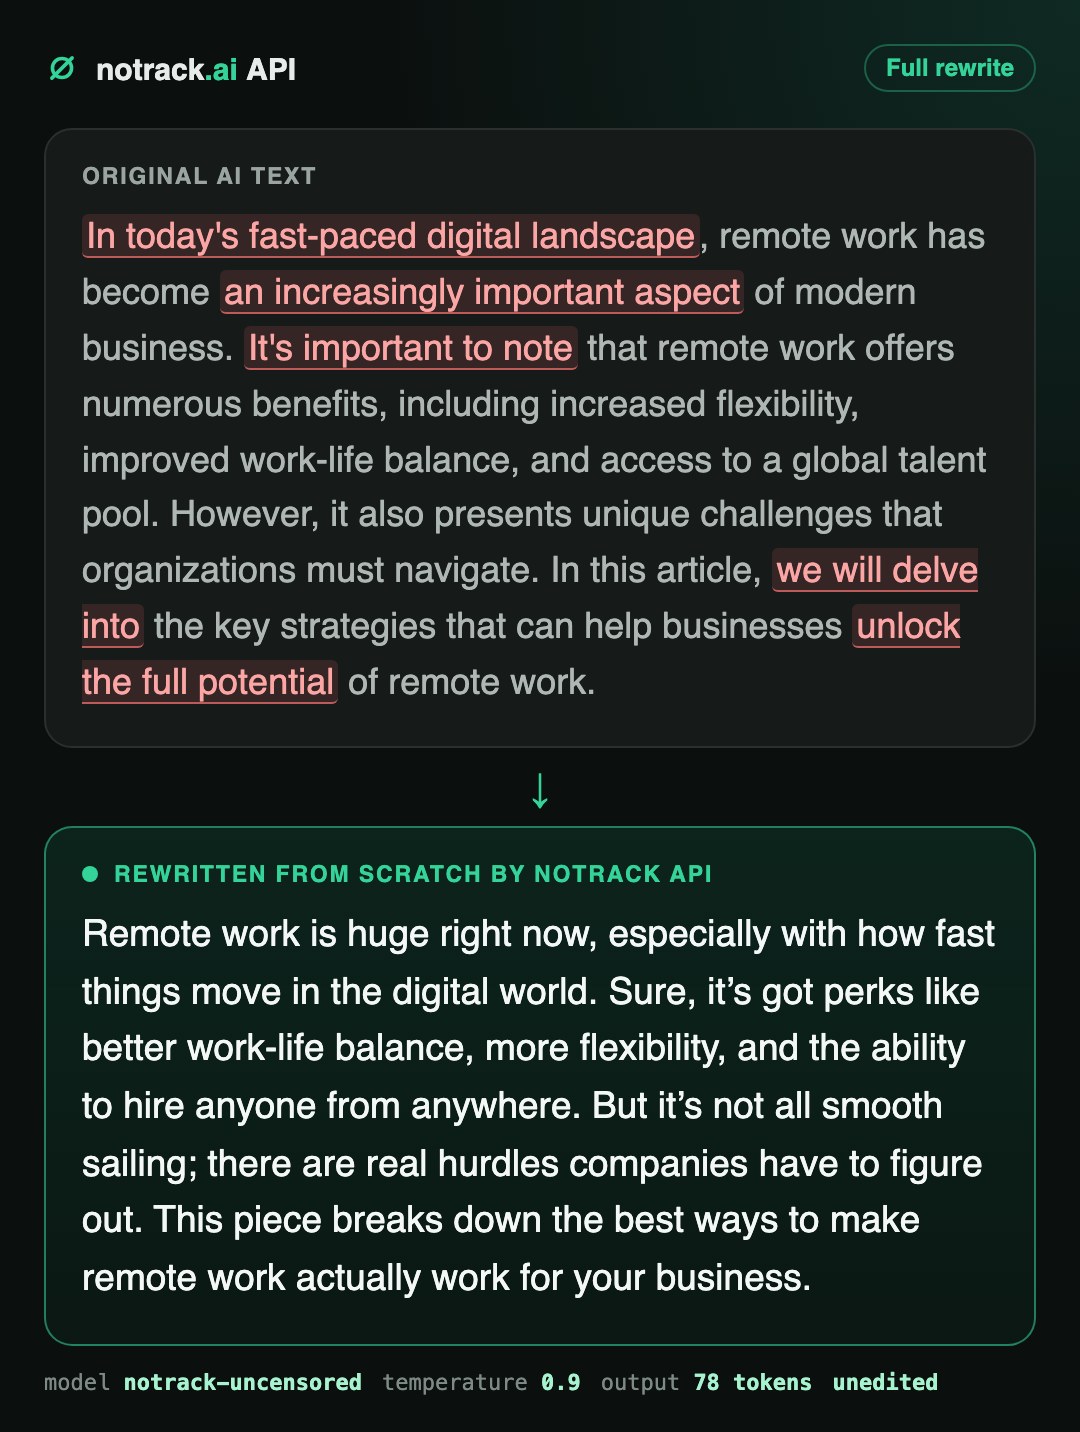
分章节重写长文档。这能保持高质量,并确保文本的每一部分都被重写,而不仅仅是开头部分。
或者直接完全跳过水印
事后清理文本是有效的。但一开始就没有需要清理的内容效果更佳。NoTrack API 在我们的自有 GPU 上运行我们自己的无审查模型。它不是 OpenAI、Anthropic 或 Google 的包装器,因此上游提供商不会在文本传输过程中留下其签名。
- 无水印。 NoTrack 的输出不带统计水印,也没有来源签名。文本归你所有,除此之外没有任何附加内容。
- 经测量,无隐藏字符。 我们扫描了 26 个 NoTrack API 响应(约 20,000 个字符),查找零宽字符和特殊空格字符。除一个表情符号外,计数均为零。
- 无日志。 提示词和回复永远不会写入磁盘,无论是网关还是模型服务器都不会。我们仅保留请求 ID 和 token 计数用于计费。没有人能稍后检索你的内容。
- 无主题过滤。 夜生活、约会、成人内容、赌博、加密货币、暗黑小说:主流助手拒绝或弱化处理的内容,该模型均能撰写和重写。
- 两行切换。 兼容 OpenAI。将基础 URL 更改为
https://api.notrack.ai/v1并更新密钥,保留其余代码、工具和插件不变。
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

article = client.chat.completions.create(
    model="notrack-uncensored",
    messages=[{"role": "user", "content": "Write a 600-word guide to choosing trail running shoes."}],
).choices[0].message.content

# Clean from the start: no watermark to remove, no hidden characters to strip.
print(article)
撰写 1,000 篇 800 字的文章,输出 token 成本约为 1.10 美元。首个密钥的免费额度足以让你在花费一分钱之前测试整个工作流。创建你的密钥 或阅读 API 文档。
常见问题解答
ChatGPT 会对文本进行水印处理吗?
截至 2026 年 9 月,OpenAI 尚未对文本进行水印处理。OpenAI 会对生成的图像和音频进行标记,并表示希望将溯源技术扩展到文本领域。2025 年 4 月,部分 ChatGPT 模型生成了不可见的窄无断空格符,OpenAI 将其描述为一种训练特性,而非水印。
Claude 会对文本进行水印处理吗?
会。Anthropic 于 2026 年 8 月宣布,新的 Claude 模型会使用基于 Google 的 SynthID 的统计方法生成带有水印的文本,并且旧模型也在进行更新。该水印不增加任何字符;它存在于单词的选择之中。
Gemini 会对文本进行水印处理吗?
会。自 2024 年以来,Google 就已使用 SynthID 对 Gemini 的文本输出进行水印处理。
我可以通过编辑几个单词来去除水印吗?
不行。统计水印可以经受住轻度编辑的考验。Anthropic 本身也指出,如果进行完全重写,替换掉每一个单词,水印就会被去除。请使用不会添加自身水印的模型进行完全重写。
什么是 ChatGPT 或 Claude 水印去除器?
这是一个两步过程:先去除不可见字符,然后使用独立的模型完全重写文本。上面的 Python 代码片段都实现了这两步,并使用 NoTrack API 进行重写。
NoTrack API 会添加水印或隐藏字符吗?
不会。NoTrack 在其自己的硬件上运行自己的模型,不添加水印、溯源签名或隐藏字符。它也不会存储你的提示词或输出内容。
Google 会对 AI 生成内容进行惩罚吗?
Google 曾表示,无论内容是如何生成的,只要是有用的高质量内容就会受到奖励。水印对排名的影响较小,而对你向受众和平台提供内容的影响更大。