
自 2026 年 8 月起,來自大型 AI 助手生成的文字已不僅僅是文字而已。Claude 與 Gemini 現在會在其選用的字詞中隱藏統計浮水印,而 OpenAI 已表示文字是 ChatGPT 的下一個目標。您無法看見它,但供應商可以偵測它,任何他們提供偵測器的人也可以。如果您建立網站、為客戶撰寫內容或進行大規模發布,以下是目前 AI 生成文字中隱藏的內容、如何檢查您自己的內容、如何移除 AI 浮水印,以及如何一開始就使用 NoTrack API 產生純淨文字。
您內容上的無形標籤
2026 年 8 月 2 日,歐盟 AI 法案(第 50 條) 的透明度規則開始生效。這些規則要求生成式 AI 供應商以機器可讀的方式標記其系統產生的內容,以便偵測為 AI 生成。大型實驗室動作迅速。
- Anthropic(Claude)。 2026 年 8 月 14 日,Anthropic 宣布,新的 Claude 模型生成的文字包含浮水印,較舊的模型則在隨後的幾個月中進行更新。偵測器 API 已針對監管機構、執法單位、媒體、事實查核員、研究人員和教育機構展開私人預覽。
- Google(Gemini)。 Gemini 自 2024 年起已為其文字輸出加上浮水印,使用的是 SynthID,這是一種 Google DeepMind 在《自然》期刊發表並於 2024 年開放原始碼的方法。Claude 的浮水印建立在相同的技術之上。
- OpenAI(ChatGPT)。 OpenAI 已經標記生成的影像和音訊,並表示希望將 內容溯源 擴展到文字。據報 OpenAI 已內部建構文字浮水印,但尚未推出。
對於只是隨意詢問食譜的使用者來說,這些都不重要。但對於任何發布 AI 輔助文字、銷售文字或將其交付給客戶的人來說,這將改變遊戲規則:你的內容現在帶有你不曾加入、無法看見且無法關閉的簽名。
兩種類型的 AI 文字浮水印
"AI 浮水印" 用於兩種截然不同的事物。了解你面對的是哪一種,決定了你該如何移除它。
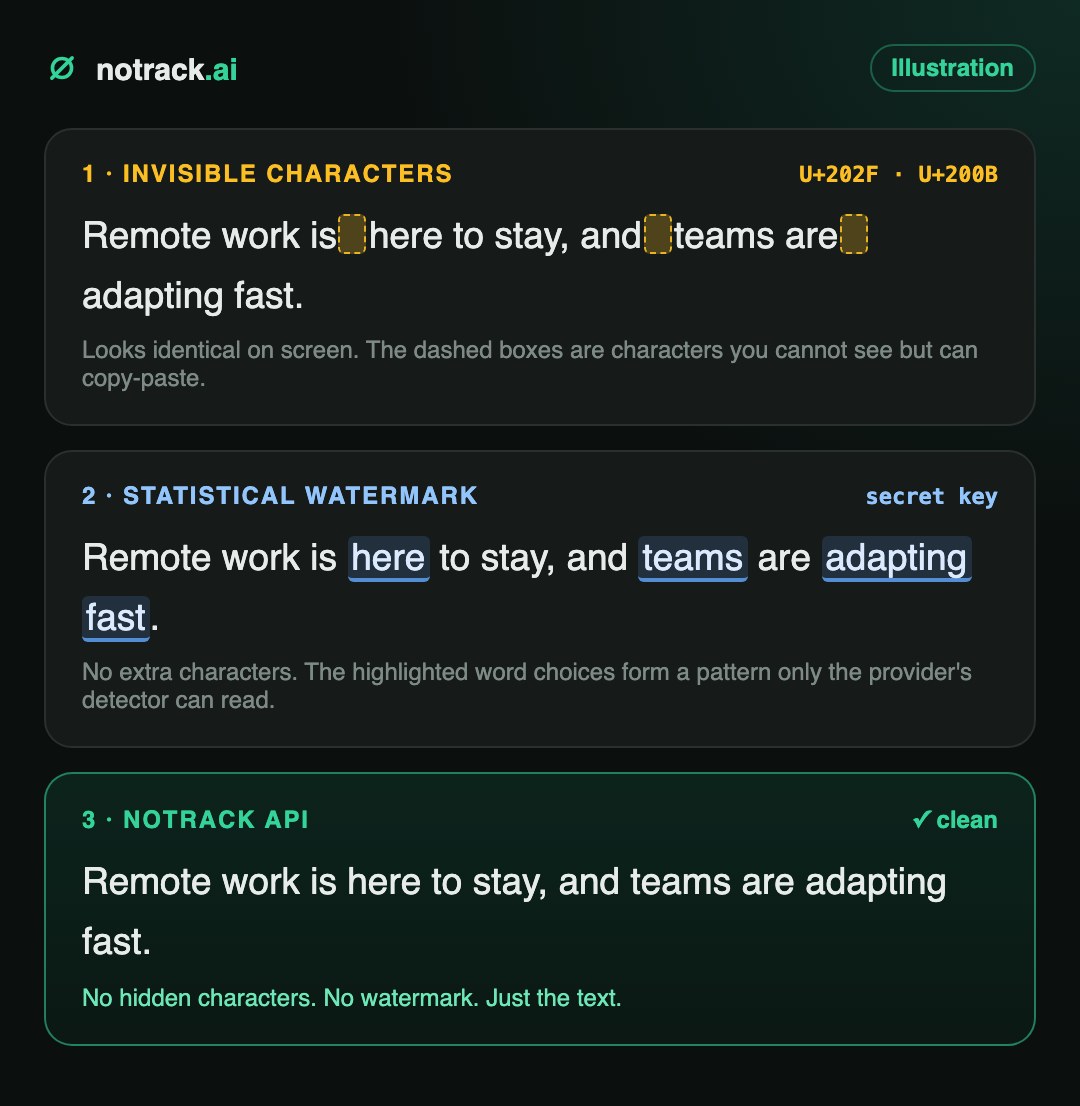
不可見字元
Unicode 字元看起來與一般空格或完全無物完全相同:零寬空格、字詞連接符、窄型無斷行空格。
- 使用簡單指令碼即可偵測
- 容易移除:將其清除或取代
- 悄悄破壞功能:搜尋、字數統計、關鍵字比對、程式碼
統計浮水印
完全沒有額外的字元。模型的用詞選擇由秘密金鑰引導,留下僅有供應商偵測器可讀取的模式。
- 對讀者及任何文字編輯器而言均不可見
- 可經受複製貼上與輕度編輯
- 大幅改寫會削弱其效力;完全重寫則會將其消除
不可見字元:ChatGPT 集
2025年4月,研究人員發現來自 OpenAI 當時新推出的 o3 和 o4-mini 模型的文本中,在原本應為普通空格的位置出現了窄無斷空格(U+202F)。當在開啟格式標記的 Word 中貼上時,這些字元顯示為小圓圈而非圓點。OpenAI 表示這些字元是大型強化學習過程中的怪癖,並非刻意設計的水印,且這些字元後來不再出現。儘管如此,這仍是一個教訓:AI 生成的文本可能包含你看不見的字元,而它們會隨著每一次複製貼上操作,跟隨文本進入你的 CMS。
統計水印:SynthID 與 Claude
語言模型會從一系列可能的候選詞中選擇下一個詞,並帶有少量隨機性。統計水印用由密鑰生成的偽隨機選擇取代了這種隨機性。對讀者而言,文本看起來完全正常;但對於持有密鑰的人來說,足夠長的文本段落會顯示出一種幾乎不可能由隨機產生的詞語選擇模式。
Claude 選擇的詞語仍然是隨機的,但現在可以檢查詞語序列,看看它是否與 Claude 在使用密鑰時會做出的選擇一致。
Anthropic,Claude 的文本水印運作原理(2026年8月)
對於出版商而言,有兩個細節很重要。文本越長,水印就越強;根據 Anthropic 的說法,輕微的編輯不會消除水印,而將每個詞都替換掉的完全重寫則會消除它。
誰對 AI 文本進行水印處理(2026年9月)
| 供應商 | 文本水印 | 類型 | 誰可以進行驗證 |
|---|---|---|---|
| Google Gemini | 可以,自 2024 年起 | 統計型(SynthID) | Google的SynthID工具 |
| Anthropic Claude | 是,2026年8月之後的新模型 | 統計(基於SynthID) | Anthropic檢測API,供監管機構、媒體、教育工作者和研究人員使用的私密預覽 |
| OpenAI ChatGPT | 尚未涵蓋文字;圖片和音訊已標記 | 文字來源已宣布為目標 | OpenAI工具(圖片和音訊今日可用) |
| NoTrack API | 否 | 無浮水印,無隱藏字元 | 無人 |
為什麼帶有浮水印的文字會傷害內容創作者
Google多年來一直表示,其內容排名依據的是品質,而非製作方式。問題出在整個產業鏈的其他環節。
- 你的客戶可以自行查證。 代理商和自由接案者交付的文字,越來越多會經過客戶使用 AI 檢測工具審查後才付款。水印會將「AI 輔助並經過精心編輯」的內容直接標記為「已標記」,完全沒有保留細節與彈性的空間。
- 平台與市場進行篩選。 發布平台、自由接案市場、廣告網路和評論網站正在導入 AI 檢測。可被偵測到的簽名是世界上最容易過濾的條件。
- 它會揭露你的工作流程。 水印會告訴任何擁有檢測工具的人,你的內容是由哪種工具撰寫的。對於內容產業來說,這是競爭情報,而你從未同意將其公開。
- 它會隨著文字出現在任何地方。 即使內容被轉載、輕度翻譯或重新發布,帶有水印的文字仍會保留其簽名。你無法審計你看不見的東西。
- 隱藏字元會導致問題。 不可見的 Unicode 會悄悄導致網站搜尋、精確比對關鍵字、字數統計、拼字檢查以及你貼上的任何程式碼出錯。它甚至會讓兩個看起來完全相同的頁面,在位元組層級產生差異。
如何檢查文字中的 AI 水印
1. 隱藏字元:秒級檢查
快速手動測試:將文字貼到 Microsoft Word 中,然後按 Ctrl+Shift+8(Mac 上為 Cmd+8)以顯示格式標記。一般空格顯示為圓點;特殊空格則顯示為小圓圈或其他符號。若要進行大規模檢查,請使用腳本:
import unicodedata

SUSPECT = {0x00A0, 0x202F, 0x2007, 0x2009, 0x200A, 0x205F, 0x3000,
           0x200B, 0x200C, 0x200D, 0x2060, 0xFEFF, 0x00AD}

def find_hidden(text: str):
    hits = []
    for i, ch in enumerate(text):
        if ord(ch) in SUSPECT or unicodedata.category(ch) == "Cf":
            hits.append((i, f"U+{ord(ch):04X}", unicodedata.name(ch, "?")))
    return hits

print(find_hidden(open("article.txt", encoding="utf-8").read()))
一個值得注意的細節:零寬連接符(U+200D)也是許多表情符號的合法組成部分,例如 🚴♂️。如果命中出現在表情符號內部,請保留原樣。
2. 統計式水印:你無法自行檢測
文字表面看不出任何痕跡。只有持有密鑰的供應商檢測器才能判斷某段文字是否帶有水印。Anthropic 的檢測 API 目前僅針對特定機構進行內部預覽,尚未對公眾開放。在實際操作中,這意味著你必須假設:如果水印模型寫了這段文字,且你沒有完全重寫它,它就會被標記。
如何去除文字中的 AI 水印
- 去除不可見字符。 將特殊空格替換為普通空格,並刪除零寬字符。安全、即時且無損。
- 使用獨立模型完全重寫。 輕微的修改會保留統計式水印。完全重寫則會改變整篇文章的句子結構和用詞,從而消除水印。使用一個不對其自身輸出進行水印處理的模型,否則你只是用另一種簽名替換了原有的簽名。
- 讓風格更具人性化。 完全重寫並加上我們 AI 文本人性化指南 中的提示詞,可以去除檢測器偏愛的套話和平淡的節奏。
- 再次掃描。 在發布之前再次運行字符檢查。這只需要幾秒鐘。
代碼步驟 1:清理字符
import re

SPACES = r"[\u00A0\u202F\u2007\u2009\u200A\u205F\u3000]"
ZERO_WIDTH = r"[\u200B\u200C\u2060\uFEFF\u00AD]"

def clean(text: str) -> str:
    text = re.sub(SPACES, " ", text)
    return re.sub(ZERO_WIDTH, "", text)
代碼步驟 2:透過 NoTrack API 進行完全重寫
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

REWRITE = ("Rewrite the user's text from scratch in your own words, the way a sharp "
           "human writer would say it to a friend. New sentence structure and new word "
           "choice everywhere, same meaning and every fact kept. Plain everyday words, "
           "contractions, short and long sentences mixed. No em dashes. "
           "Output only the rewrite.")

def rewrite(text: str) -> str:
    r = client.chat.completions.create(
        model="notrack-uncensored",
        temperature=0.9,
        messages=[{"role": "system", "content": REWRITE},
                  {"role": "user", "content": clean(text)}],
    )
    return r.choices[0].message.content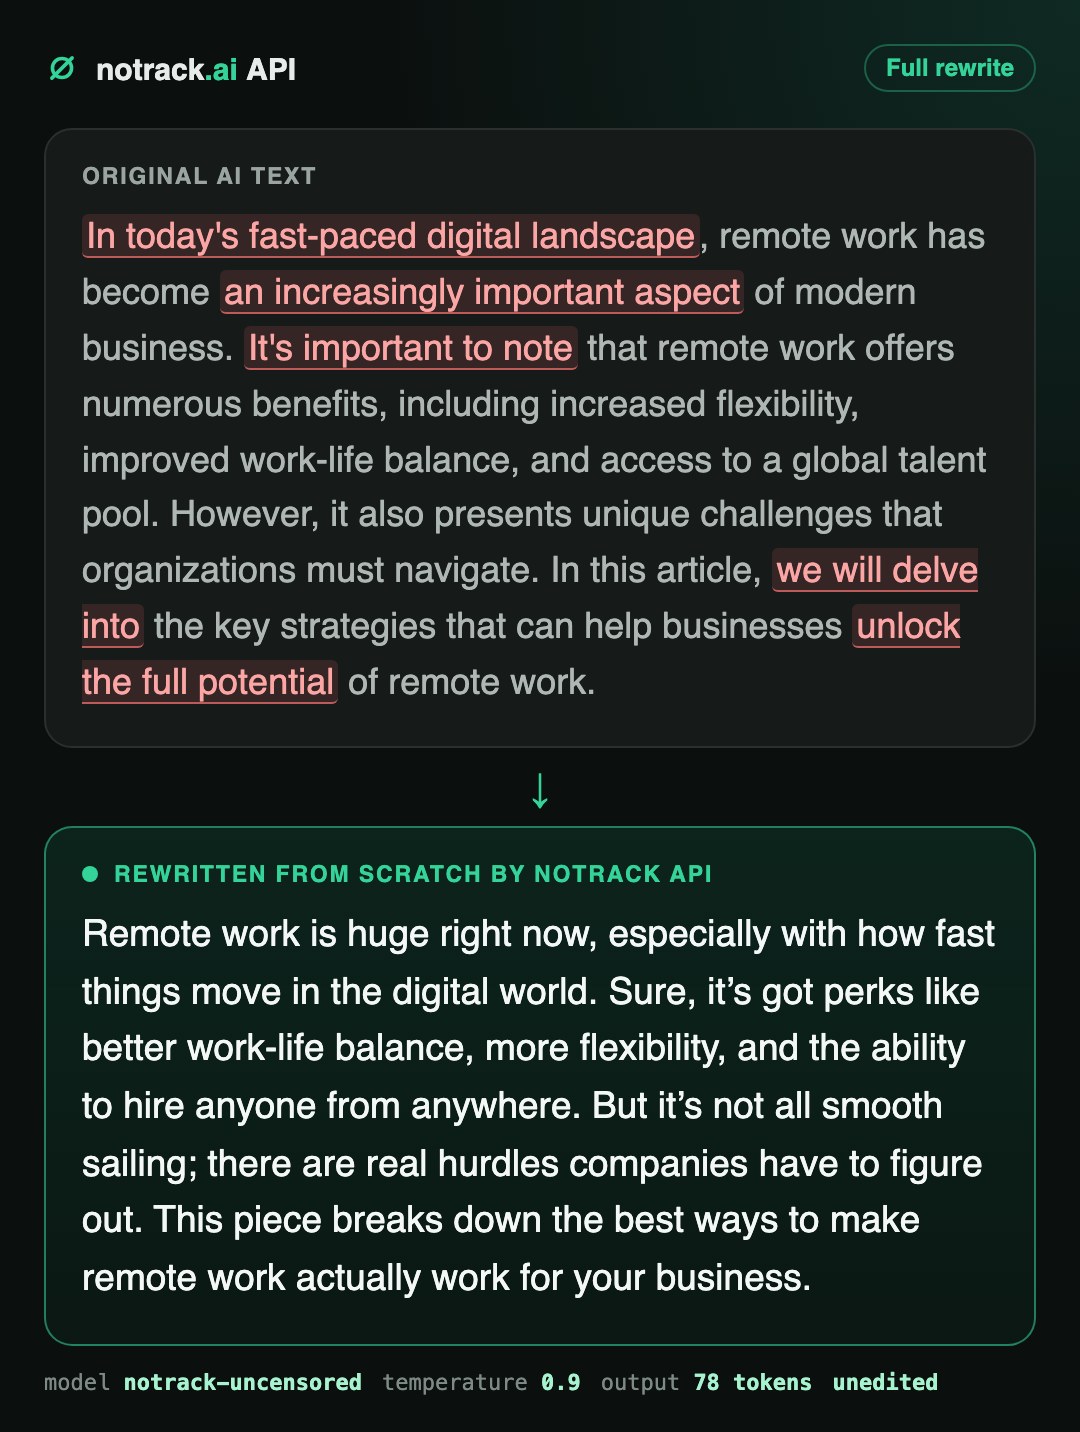
分章節重寫長文檔。這能保持高質量,並確保文本的每一部分都被重寫,而不僅僅是開頭部分。
或者完全跳過水印
事後清理文本是有效的。但根本沒有需要清理的內容則效果更好。NoTrack API 在我們自己的 GPU 上運行我們自己的無審查模型。它不是 OpenAI、Anthropic 或 Google 的封裝,因此上游供應商不會在文本傳輸過程中留下它們的簽名。
- 無水印。 NoTrack 的輸出沒有統計式水印,也沒有來源證明簽章。文字屬於你,不會附加其他東西。
- 無隱藏字元,經測量確認。 我們掃描了 26 筆 NoTrack API 回應,總計約 20,000 個字元,檢查是否有零寬度字元與特殊空格。除了一個表情符號外,計數為零。
- 無日誌。 提示詞與回覆都不會寫入磁碟,無論是閘道器還是模型伺服器都不會。我們僅保留請求 ID 與 token 計數用於帳單。沒有人能稍後反查你的內容。
- 無主題過濾。 夜生活、約會、成人、賭博、加密貨幣、暗黑小說:主流助手拒絕或軟化處理的內容,該模型都能撰寫與改寫。
- 兩行切換。 與 OpenAI 相容。將基礎網址改為
https://api.notrack.ai/v1並更換金鑰,其餘程式碼、工具和插件保持不變。
from openai import OpenAI

client = OpenAI(base_url="https://api.notrack.ai/v1", api_key="sk-notrack-...")

article = client.chat.completions.create(
    model="notrack-uncensored",
    messages=[{"role": "user", "content": "Write a 600-word guide to choosing trail running shoes."}],
).choices[0].message.content

# Clean from the start: no watermark to remove, no hidden characters to strip.
print(article)
撰寫 1,000 篇 800 字的文章,輸出 token 成本約為 1.10 美元。你的第一支金鑰的免費額度足以讓你測試整個工作流程,在花費任何錢之前即可驗證。建立你的金鑰 或閱讀 API 文件。
常見問題
ChatGPT 會為其文字加上浮水印嗎?
截至 2026 年 9 月為止不會。OpenAI 會為生成的影像和音訊加上浮水印,並表示希望將溯源技術延伸至文字領域。2025 年 4 月,部分 ChatGPT 模型產生了不可見的窄型無斷行空白字元,OpenAI 將其描述為訓練過程中的怪癖,而非浮水印。
Claude 會為其文字加上浮水印嗎?
會。Anthropic 於 2026 年 8 月宣布,新的 Claude 模型會使用基於 Google 的 SynthID 的統計方法來生成帶有浮水印的文字,且舊版模型正在進行更新。這種浮水印不會增加任何字元,而是存在於單字的選擇之中。
Gemini 會為其文字加上浮水印嗎?
會。自 2024 年起,Google 就已為 Gemini 的文字輸出內容加上由 SynthID 提供的浮水印。
我可以透過編輯幾個字詞來移除浮水印嗎?
不行。統計浮水印能夠抵擋輕度的編輯修改。Anthropic 本身也指出,若進行完全改寫,替換掉每一個字詞,則可移除浮水印。請使用不會額外添加自身浮水印的模型進行完整改寫。
ChatGPT 或 Claude 浮水印移除器是什麼?
這是一個兩步驟的過程:先移除不可見字元,然後使用獨立模型完全改寫文字。上述的 Python 程式碼片段同時具備這兩種功能,並使用 NoTrack API 來進行改寫。
NoTrack API 會添加浮水印或隱藏字元嗎?
不會。NoTrack 在其自有硬體上運行其自有模型,不會添加浮水印、溯源標記或隱藏字元。它也不會儲存您的提示詞或輸出內容。
Google 會對 AI 生成內容進行懲罰嗎?
Google 曾表示,無論內容如何產生,只要是有幫助且高品質的內容都會獲得獎勵。浮水印對於搜尋排名影響較小,而對您將內容提供給的受眾和平台影響較大。